AI 看图有两个老大难:一是糊——图片压缩、分辨率不够、字太小看不清;二是装——看不清就硬猜,猜错了还理直气壮。
我们把「看图」拆成一条决策管线:先看整体,判断要不要放大局部;真看不清,就升级清晰度重来;最后交叉验证,不许硬认。识别引擎可以随便换,管线永远一致——换眼睛,不换脑子。
还顺手解决了一个更根本的问题:有些模型根本没有「眼睛」。我们给纯文本模型加装了视觉识别通道——没有眼睛的模型,照样能看图、能读屏幕、能干活。
图片识别全链路优化:压缩开局、局部细读、看不清升级、交叉验证。还给纯文本模型加装视觉识别——没有眼睛的模型,也能看图。
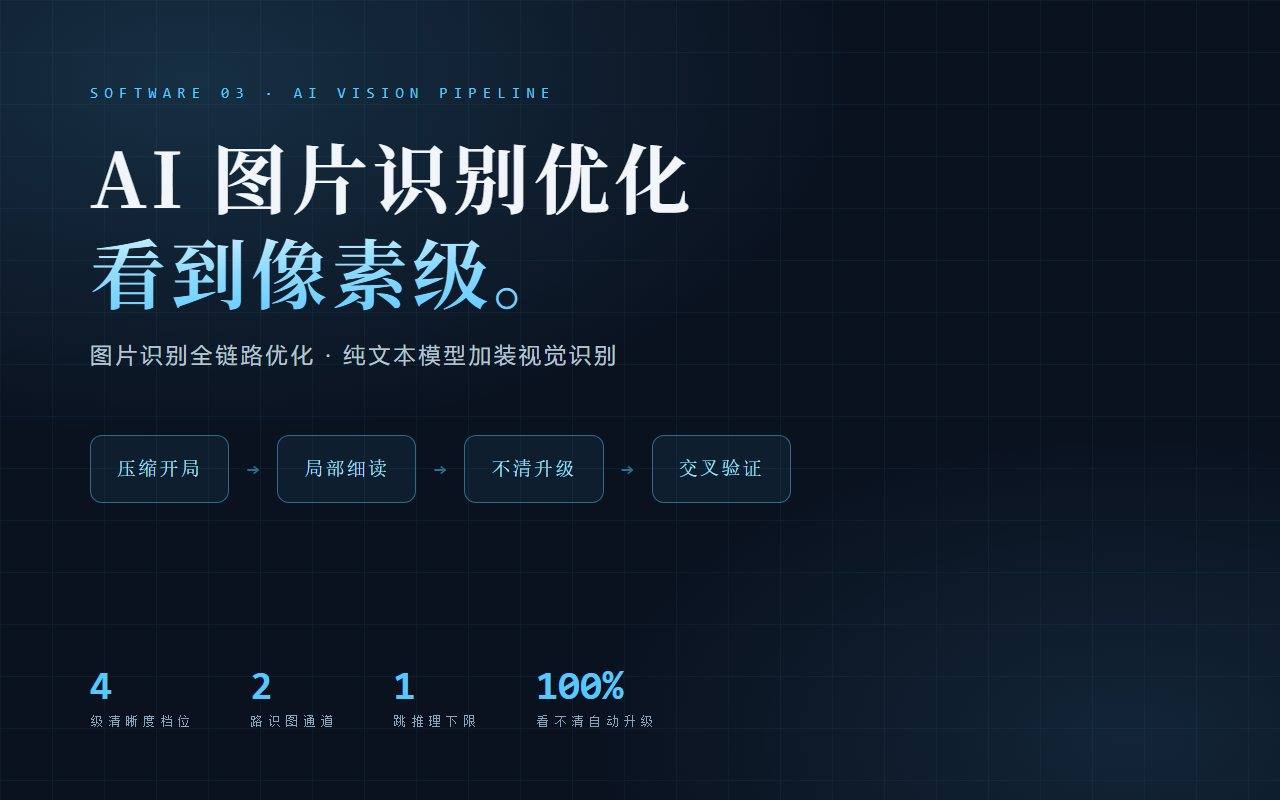
AI 看图有两个老大难:一是糊——图片压缩、分辨率不够、字太小看不清;二是装——看不清就硬猜,猜错了还理直气壮。
我们把「看图」拆成一条决策管线:先看整体,判断要不要放大局部;真看不清,就升级清晰度重来;最后交叉验证,不许硬认。识别引擎可以随便换,管线永远一致——换眼睛,不换脑子。
还顺手解决了一个更根本的问题:有些模型根本没有「眼睛」。我们给纯文本模型加装了视觉识别通道——没有眼睛的模型,照样能看图、能读屏幕、能干活。
先喂轻量压缩图探路——省流量省时间,细节不够再加码,不一上来就下重药。
细节密集、小字多的画面自动裁剪放大重读;简单场景不浪费算力。
识别置信度不够自动升档重试,四档清晰度逐级加码,直到看清为止。
关键结果多路比对,不许「差不多先生」过关。
给没有眼睛的纯文本模型外接视觉识别通道——照样能看图、能读屏幕、能干活。
识别引擎随时替换升级,管线逻辑永远一致——换眼睛,不换脑子。
能一跳推理绝不两跳。省的是真金白银的图 token,和真实等待时间。
小字看不清就放大原图重认——原始路径永远保留,宁可重看,不许瞎猜。
实测发现:会话长度才是速度主宰,识图开销本身微不足道——优化目标从「省识图」改为「省跳数和重放」。
决策层(压缩→局部→升级→验证)和执行层(具体识别引擎)彻底分开——管线定型后,引擎随便换。
有眼睛的走原生识图,没眼睛的走外接视觉脚本——分流自动判断,殊途同归。
真实任务里持续校准档位与裁剪策略,识别不准的场景逐个消灭。
这套管线现在每天在用:识图、读截图、验结果,全走这条链路。四档清晰度、两路通道、一跳推理下限——效率是真的算出来的。
最关键的一条原则被反复验证:看不清就别硬认,放大了重看——这比任何压缩算法都重要。
看不清就别硬认,放大了重看——这比任何压缩算法都重要。PIPELINE RULE · 管线第一原则
多模态大模型贵、慢、难控。我们的路线相反:保留纯文本模型的推理强项,用一条视觉适配管线把图像"翻译"成它擅长处理的结构化描述——模型没变,能力变了。同样的任务,成本近乎为零,可控性反而更高。
识别不准的系统到处都是,关键是知道哪里不准、怎么变准。这条管线会统计每类场景的错误分布,把最容易翻车的类别揪出来单独调参——准确率不是靠堆算力堆出来的,是靠一轮轮定向优化磨出来的。
| 路线 | 纯文本模型 | 通用多模态大模型 | 本方案 |
|---|---|---|---|
| 看得见图 | ✗ | ✓ | ✓ 视觉适配层补上 |
| 成本 | ✓ 极低 | ✗ 高 | ✓ 近乎为零 |
| 可控性 | ✓ 高 | ✗ 黑盒 | ✓ 全链路可调 |
| 推理能力 | ✓ 强 | △ 被视觉任务稀释 | ✓ 保留文本强项 |
| 定向优化 | ✗ 无从下手 | ✗ 只能换模型 | ✓ 错误分布驱动 |
| 规格 | 参数 |
|---|---|
| 管线 | 图像 → 特征提取 → 语义桥接 → 文本推理 → 校准 |
| 优化手段 | 错误分布分析 + 定向调参 + 回归验证 |
| 成本模型 | 轻量视觉层 + 纯文本推理,替代重多模态调用 |
| 可移植性 | 管线独立封装,可给任何纯文本模型"开眼" |
纯文本模型成功加装视觉识别,准确率显著跃升。
按场景打包的专用识别配方,一键切换。
错误数据自动回流,识别效果随使用量自我进化。
v1.3.0v1.0.0